
Quy tắc Crop-to-Input: Khi Detection Cascade Có Ích và Khi Nào Phản Tác Dụng
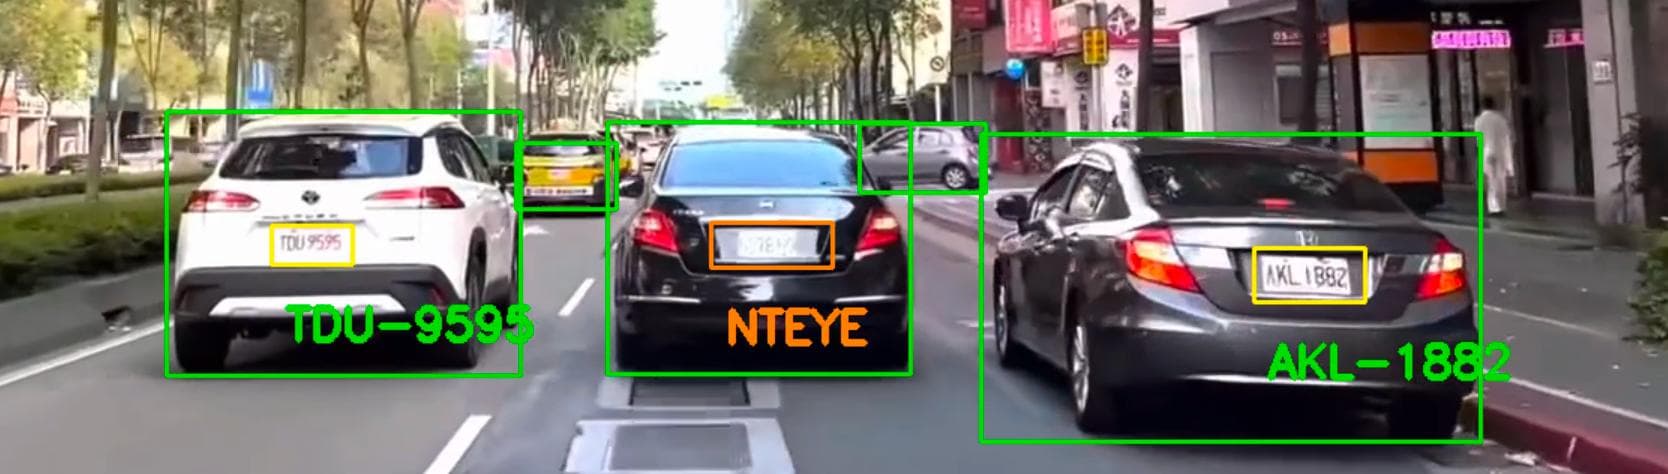
Chúng tôi thêm một tầng vehicle detection phía trước plate detector, theo đúng kiến trúc LPR ba tầng tham chiếu của NVIDIA. Một clip test tăng 3.4 lần độ phủ biển số, nhưng camera cổng production lại giảm 23 lần. Khác biệt nằm ở một phép đo duy nhất: tỷ lệ crop-to-input.
Tóm tắt nhanh
- Cascade vehicle → plate → OCR là một kiến trúc phổ biến và đã được kiểm chứng cho nhận dạng biển số xe (LPR), kể cả trong pipeline LPR tham chiếu của NVIDIA. Nó có thể hoạt động cực tốt: trên một clip test, cascade này tăng độ phủ phát hiện biển số lên 3.4 lần và số vehicle track ổn định (settled) lên 5.7 lần.
- Trên camera cổng production của chúng tôi, cùng một thay đổi kiến trúc lại cho kết quả ngược lại: số lượt đọc biển số được chấp nhận giảm từ 46 xuống còn 2 trong cùng khung 5 phút, tức giảm 23 lần.
- Yếu tố dự đoán mạnh nhất trong các thử nghiệm của chúng tôi không phải là kiến trúc, mà là tỷ lệ crop-to-input: kích thước của vùng crop xe (vehicle crop) ở tầng trước so với độ phân giải input của plate detector.
- Khi vehicle crop nhỏ hơn đáng kể so với input của detector phía sau, cascade phần lớn chỉ đang nội suy (interpolation) chứ không thực sự tạo ra một góc nhìn độ phân giải cao hơn có ý nghĩa cho biển số.
- Cascade còn kéo theo một ràng buộc khác: recall toàn trình bị chặn trên bởi từng tầng phía trước. Một vehicle detector lệch domain có thể khiến một plate detector rất mạnh không bao giờ nhìn thấy đối tượng.
- Cuối cùng, chúng tôi gỡ bỏ tầng vehicle pre-filter khỏi pipeline production này và dồn ngân sách GPU vào đúng tầng đang thiếu độ phân giải. Tăng độ phân giải input của plate detector và nâng cấp model cho ra kết quả đo được +37% cải thiện phát hiện thực địa, mà không phụ thuộc vào khung hình của xe.
Bài học ở đây không phải là detection cascade là xấu.
Bài học là:
Trước khi thêm một tầng crop-and-redetect, hãy đo xem vùng crop có thực sự chứa đủ pixel nguồn để việc đó đáng làm hay không.
Kiến trúc trông có vẻ hiển nhiên đúng
Một kiến trúc phổ biến cho nhận dạng biển số xe là:
Full frame
    ↓
Vehicle detection
    ↓
Vehicle crop
    ↓
Plate detection
    ↓
Plate crop
    ↓
OCR
NVIDIA dùng cấu trúc ba tầng tổng quát này trong implementation LPR tham chiếu của họ, và lý do đưa ra khá trực quan.
Một biển số xe có thể chỉ chiếm một phần rất nhỏ của khung hình 1080p hay 4K. Thay vì bắt plate detector tìm kiếm trên toàn bộ ảnh, hãy phát hiện xe trước, crop nó lại, rồi chạy plate detector trên một vùng hẹp hơn nhiều.
Thoạt nhìn, điều này giống như zoom kỹ thuật số.
Đôi khi đúng là vậy.
Đôi khi không phải vậy.
Chúng tôi triển khai cascade này và so sánh với pipeline hai tầng hiện có, trên cùng phần cứng, cùng clip và cùng khung thời gian cố định.
Trên một clip, cascade tốt hơn rõ rệt.
Trên camera cổng production thực tế của chúng tôi, nó lại tệ hơn rõ rệt.
Kiến trúc không hề thay đổi.
Hình học (geometry) của cảnh quay thì có.
Chúng tôi đã so sánh những gì
Baseline production của chúng tôi là một pipeline phát hiện biển số trực tiếp:
Full frame
    ↓
Plate detector
    ↓
Plate tracker
    ↓
OCR
Pipeline thử nghiệm đưa vehicle detection lên trước:
Full frame
    ↓
Vehicle detector
    ↓
Vehicle tracker
    ↓
Vehicle crop
    ↓
Plate detector
    ↓
OCR
Đây không phải một bản triển khai đồ chơi mô phỏng sơ sài một cascade.
Một khi vehicle detection trở thành tầng chính, toàn bộ tracking identity, logic settle, xử lý confidence và metadata phía sau đều phải chuyển theo. Biển số trở thành một object con gắn với một vehicle đang được track, thay vì là object chính được track trực tiếp như trước.
Baseline production
- Plate detector:
plate_yolo11s.onnx - Input: 960 x 960
- Tracker: NvDCF, track các object là biển số
- OCR:
cct_xs_v2_vn_finetuned - OCR input: 64 x 128
Cascade
- Vehicle detector: YOLO12s / YOLO26n
- Input vehicle detection: lớp 640
- Tracker: NvDCF, track các object là xe
- Plate detector chạy trên vùng ROI của xe
- Cùng model OCR ở phía sau
Runtime
- NVIDIA RTX A4000 16 GB
- DeepStream 7.1
- TensorRT 10.3
- FP16
Cả hai kiến trúc đều được đánh giá trên cùng một host và cùng một output pipeline.
Ba clip, ba hình học khác nhau
Chúng tôi cố tình chọn test trên các cảnh mà xe chiếm tỷ lệ khác nhau trong khung hình nguồn.
| Clip | Cảnh quay | Khung hình xe |
|---|---|---|
| Cổng production | Camera cổng thật, góc rộng | Nhỏ và ở xa; chiều rộng xe trung vị ≈ 146 px |
| Đường xe máy | Cảnh quay tầm gần ngang đường | Tỷ lệ xe nhỏ / hỗn hợp |
| Camera cận cảnh | Camera đã được canh khung sát vào xe | Chiều rộng xe trung vị ≈ 769 px |
Với mỗi clip, chúng tôi đo:
- số lần plate-stage được gọi,
- độ phủ overlay của biển số,
- số lượt đọc OCR được chấp nhận,
- số track đã settle,
- số chuỗi biển số riêng biệt,
- mức sử dụng GPU,
- throughput output.
Độ phủ overlay được đo bằng chương trình, không phải ước lượng bằng mắt.
Mọi so sánh đều được chạy nối tiếp nhau, đối chiếu trực tiếp với baseline hiện tại.
Chi tiết này quan trọng: có hai con số từ báo cáo nội bộ trước đó không tái hiện được khi đo lại, nên chúng tôi loại chúng khỏi phân tích thay vì giữ lại.
Kết quả: cùng một cascade, hai kết cục trái ngược
| Chỉ số | Cổng production | Đường xe máy | Camera cận cảnh |
|---|---|---|---|
| Chiều rộng xe trung vị | ~146 px | Nhỏ / hỗn hợp | ~769 px |
| Vehicle crop cỡ lớn | ~1% trên scale input phía sau | Hỗn hợp | ~94% trên scale input phía sau |
| Kết quả hai tầng | 46 reads / 5 phút | 10.2% độ phủ biển số | 97.6% độ phủ |
| Kết quả cascade | 2 reads / 5 phút | 35.0% độ phủ biển số | 96.9% độ phủ |
| Thay đổi | -96% / giảm 23 lần | +3.4 lần | Gần như không đổi |
| Track đã settle | 5 → 5 | 6 → 34 | 7 → 6 |
| Biển số riêng biệt | không có dữ liệu | 6 → 27 | 2 → 2 |
| GPU sử dụng thêm | +45 điểm phần trăm | +17 điểm | Tương đương |
| Throughput output | Không đổi | 99.7% FPS nguồn | 100% |
Điều đáng chú ý không đơn giản là cascade lúc thì tốt lúc thì tệ.
Mà là hành vi của nó tương quan chặt với lượng ảnh nguồn thật sự có trong vùng crop trước khi resize.
Điều đó dẫn chúng tôi tới một chỉ số hữu ích hơn.
Tỷ lệ crop-to-input
Định nghĩa:
r = kích thước crop đặc trưng / kích thước input của detector phía sau
Theo chiều rộng:
r_w = vehicle_crop_width / detector_input_width
và tương tự cho chiều cao:
r_h = vehicle_crop_height / detector_input_height
Bạn cũng có thể tính theo diện tích, nhưng chiều rộng và chiều cao thường dễ diễn giải hơn trong thực tế vận hành.
Ba chế độ (regime) trông đại khái như sau:
r << 1
Upsampling mạnh

r ≈ 1
Gần với scale gốc

r > 1
Downsampling
Cách nhìn này hữu ích hơn nhiều so với bất kỳ ngưỡng pixel cố định nào.
Một quy tắc "640 pixel" chỉ đúng cho detector nào có chiều input liên quan đúng bằng 640 pixel.
Đổi model sang 960, 1280, hay độ phân giải khác thì ngưỡng tuyệt đối đó cũng đổi theo.
Đại lượng tổng quát chính là tỷ lệ (ratio) này.
Vì sao tỷ lệ này quan trọng
Giả sử detector phía sau kỳ vọng chiều rộng input là D, trong khi crop từ tầng trước chỉ rộng C pixel.
Nếu:
C = 150 px
D = 640 px
thì:
r ≈ 0.23
Vùng crop phải được phóng to khoảng:
640 / 150 ≈ 4.3 lần
trước khi đưa vào inference.
Điều đó không có nghĩa là detector đột nhiên nhận được nhiều thông tin thị giác gấp bốn lần.
Nội suy (interpolation) tạo ra thêm các mẫu (sample), chứ không tạo ra thêm chi tiết thật của cảnh.
Số pixel camera thật đại diện cho biển số trước khi resize không hề tăng lên.
So sánh với trường hợp:
C = 770 px
D = 640 px
Lúc này:
r ≈ 1.20
Vùng crop đang bị downsample, chứ không phải phóng to mạnh.
Đây là một chế độ vận hành khác về bản chất.
Vùng crop chứa đủ pixel nguồn để việc tách riêng chiếc xe có thể giảm nền gây nhiễu trong khi vẫn giữ được chi tiết thị giác có ý nghĩa.
Crop không tự động đồng nghĩa với zoom
Sự khác biệt này đã thay đổi cách chúng tôi nghĩ về detection theo cascade.
Một phép crop có thể làm tăng tỷ lệ input của model bị chiếm bởi mục tiêu, nhưng đó không giống với việc tăng lượng thông tin mà camera thực sự thu được.
Nếu biển số gốc chỉ được biểu diễn bởi rất ít pixel camera, phép nội suy không thể tái tạo lại chi tiết chưa từng được ghi nhận.
Đây chính là "thuế phóng đại" (magnification tax) của một cascade.
Nhưng crop-to-input ratio là một yếu tố dự đoán, không phải một định luật
Chúng tôi không xem r = 1 là một ranh giới toán học phổ quát, nơi cascade bỗng nhiên trở nên tốt.
Việc crop vẫn có thể có ích ngay cả khi thấp hơn ngưỡng đó.
Ví dụ, nó có thể:
- loại bỏ đáng kể nền gây nhiễu,
- chuẩn hóa scale của đối tượng,
- tăng tỷ lệ mục tiêu chiếm trong input của detector,
- khớp tốt hơn với phân bố dữ liệu huấn luyện của model phía sau,
- loại bỏ các object lân cận gây nhầm lẫn,
- tương tác thuận lợi với receptive field của detector.
Tương tự, một crop lớn cũng không đảm bảo thành công.
Các thử nghiệm của chúng tôi ủng hộ một kết luận hẹp hơn nhưng hữu ích hơn:
Crop-to-input ratio là yếu tố dự đoán mạnh nhất mà chúng tôi quan sát được, cho việc cascade cụ thể này giúp ích hay gây hại trên các hình học triển khai khác nhau.
Đây là một chỉ số chẩn đoán, không phải một hằng số phổ quát.
Và nó rất rẻ để đo.
Kiểu thất bại thứ hai: cascade khuếch đại tổn thất recall
Độ phân giải không phải cách duy nhất khiến kiến trúc này thất bại.
Trên một clip ban đêm dùng IR, bản thân vehicle detector - vốn được huấn luyện chủ yếu trên ảnh phổ nhìn thấy (visible-spectrum) thông thường - chỉ phát hiện được xe trên khoảng 46% số frame.
Điều đó tạo ra một trần chặn cứng.
Xét:
Recall của vehicle detector = Rv
Recall của plate detector   = Rp
Tỷ lệ OCR thành công        = Ro
Tỷ lệ thành công toàn trình, ở dạng đơn giản hóa, xấp xỉ:
R_pipeline ≈ Rv × Rp × Ro
Nếu:
Rv = 0.46
thì ngay cả một hệ thống phía sau hoàn hảo cũng không thể cứu lại 54% frame còn lại.
Plate detector không bao giờ nhận được những crop đó.
Đây là một vấn đề khác với vấn đề độ phân giải của crop.
Vấn đề đầu là vấn đề hình học / thông tin.
Vấn đề sau là vấn đề domain-shift / recall.
Chúng đòi hỏi những cách khắc phục khác nhau.
Vì sao việc tinh chỉnh (tuning) không cứu được nó
Chúng tôi đã thử một số điều chỉnh hiển nhiên.
Thêm padding cho crop
Chúng tôi mở rộng vehicle crop thêm 5% để tính đến các biển số nằm sát hoặc hơi lệch ra ngoài bounding box của xe.
Điều này không giải quyết được vấn đề.
Với những chiếc xe vốn đã nhỏ, việc thêm padding lại làm giảm tỷ lệ mà biển số chiếm trong input phía sau.
Giảm ngưỡng confidence của vehicle detector
Việc này sinh ra nhiều candidate vehicle crop hơn.
Nhưng thêm các phát hiện xe chất lượng thấp không chuyển hóa thành nhiều lượt đọc biển số đúng hơn.
Chúng tôi chỉ đang đưa thêm các crop kém chắc chắn vào một tầng vốn đã bị giới hạn bởi độ phân giải nguồn.
Giảm ngưỡng OCR
Việc này tác động đến một tầng khác của pipeline và không thể khôi phục lại thông tin thị giác chưa từng được ghi nhận.
Với các biển số quá nhỏ, việc giảm ngưỡng phần lớn chỉ chuyển hệ thống từ trạng thái không đọc được sang chấp nhận một kết quả đọc chất lượng thấp như thể nó đúng.
Với hệ thống kiểm soát ra vào, điều đó có thể còn tệ hơn.
Các thử nghiệm liên tục dẫn về cùng một kết luận:
vấn đề cốt lõi của chúng tôi là thiếu pixel nguồn, chứ không phải vấn đề ngưỡng.
Đối chiếu với các kiến trúc cascade tham chiếu
Kết quả này không có nghĩa là kiến trúc tham chiếu của NVIDIA sai.
Nó có nghĩa là hình học triển khai (deployment geometry) rất quan trọng.
Một cascade có thể rất phù hợp cho:
- camera trạm thu phí,
- làn đường được canh khung chặt,
- camera đặt gần xe,
- các luồng video độ phân giải cao, nơi xe chiếm phần lớn diện tích ảnh.
Nó có thể kém hấp dẫn hơn cho:
- camera cổng góc rộng,
- camera đường phố ở xa,
- camera tổng quan nhiều làn đường,
- các triển khai nơi xe chỉ chiếm một phần nhỏ của ảnh nguồn.
Một kiến trúc tham chiếu không thể đảm bảo rằng cảnh quay thực tế thỏa mãn cùng các giả định về hình học và domain mà kiến trúc đó hoạt động tốt.
Vì vậy, nên nhìn kiến trúc này như một điều kiện có ràng buộc:
Kiến trúc tham chiếu
        +
hình học camera
        +
độ phân giải nguồn
        +
độ phân giải input của model
        +
mức khớp domain
        =
hành vi thực tế trên production
Một bài học khác: "confidence" có thể mang nghĩa sai
Trong cùng quá trình điều tra này, chúng tôi phát hiện một vấn đề production khác, không liên quan trực tiếp nhưng quan trọng.
Cổng pass / uncertain ban đầu của chúng tôi dùng một điểm đồng thuận theo kiểu vote (voting-consensus score).
Các kết quả OCR lặp lại của cùng một object đang được track được tổng hợp lại, và mức đồng thuận giữa các frame được xem như là confidence.
Ngưỡng đặt ra là 0.6.
Nhưng trong giao thông thực tế, ngưỡng này gần như không bao giờ từ chối bất cứ thứ gì. Điểm đồng thuận thấp nhất quan sát được xấp xỉ 0.964.
Một chiếc xe di chuyển chậm tạo ra các crop biển số gần như giống hệt nhau qua nhiều frame liên tiếp. Nếu OCR liên tục đọc sai cùng một ký tự, sự đồng thuận lặp lại đó chỉ càng củng cố thêm lỗi sai đó.
Chúng tôi đã đổi cổng này sang dùng chính confidence nhận dạng của model OCR, thay vì coi sự đồng thuận lặp lại là bằng chứng cho tính đúng đắn.
Bài học rộng hơn ở đây là:
Đừng bao giờ tin một chỉ số được gọi là "confidence" cho đến khi bạn biết chính xác nó đang đo loại bất định (uncertainty) nào.
Confidence theo kiểu đồng thuận và confidence của model trả lời hai câu hỏi khác nhau.
Ràng buộc triển khai quan trọng hơn độ chính xác trên benchmark
Một bài học thực tế khác đến từ việc đánh giá các plate detector thay thế.
Một số model pretrained trông mạnh hơn về độ chính xác thô.
Nhưng chúng tôi vẫn không thể triển khai chúng trực tiếp.
Một số chỉ được phân phối dưới dạng đồ thị ONNX end-to-end, với phần post-processing được nhúng sẵn vào cấu trúc đồ thị, không khớp với các giả định về output cố định và batching của pipeline triển khai DeepStream 7.1 / TensorRT của chúng tôi, nếu không export lại hoặc chỉnh sửa đồ thị.
Một detector hữu ích không đơn thuần là model có độ chính xác cao nhất trên benchmark.
Giá trị thực tế trên production còn phụ thuộc vào:
- độ chính xác,
- độ trễ (latency),
- khả năng export,
- khả năng tương thích batching,
- độ ổn định khi vận hành,
- độ bền vững trước lệch domain.
Một model không thể tích hợp một cách đáng tin cậy chưa chắc là model production tốt nhất, bất kể vị trí trên bảng xếp hạng.
Điều thực sự hiệu quả
Sau khi xác định chính plate detector là tầng đang thiếu độ phân giải, chúng tôi chuyển ngân sách GPU sang đó.
Thay vì:
Vehicle detector
      ↓
crop
      ↓
Plate detector
chúng tôi quay lại với:
Frame độ phân giải cao hơn
        ↓
Plate detector đã được cải tiến
Việc tăng độ phân giải input của plate detector và thay model cho ra kết quả đo được:
+37% cải thiện phát hiện thực địa
mà không tạo ra sự phụ thuộc vào hình học của vehicle crop.
Cải thiện này không miễn phí - inference ở độ phân giải cao hơn tốn thêm thời gian GPU.
Nhưng nó có thể dự đoán được.
Quan trọng hơn, cải thiện này nhắm đúng vào tầng thực sự cần thêm thông tin không gian.
Một quy tắc quyết định tốt hơn cho detection cascade
Giờ đây, chúng tôi đánh giá một cascade trước khi triển khai nó.
1. Đo hình học triển khai
Thu thập phân bố bounding box ở tầng trước từ camera thực tế: P10, P25, P50, P75 và P90 cho chiều rộng, chiều cao và diện tích crop.
Đừng dựa vào cảnh quay demo.
2. Chuẩn hóa theo input phía sau
Tính:
r_w = crop_width  / detector_input_width
r_h = crop_height / detector_input_height
Nhờ vậy, phép đo vẫn còn ý nghĩa ngay cả khi model hoặc độ phân giải input thay đổi.
3. Đo chính đối tượng mục tiêu
Tỷ lệ crop ở tầng trước chỉ là một proxy.
Suy cho cùng, đại lượng quan trọng nhất là:
Có bao nhiêu pixel nguồn thật đại diện cho đối tượng mà model phía sau phải nhận dạng?
Với LPR, điều đó nghĩa là đo chiều rộng và chiều cao của biển số trong khung hình camera gốc.
Với nhận dạng khuôn mặt, đó có thể là khoảng cách giữa hai mắt hoặc chiều rộng khuôn mặt.
Với phân tích văn bản, chiều cao ký tự có thể quan trọng hơn kích thước trang.
4. Đo recall của tầng trước một cách độc lập
Trước khi thêm Tầng A → Tầng B, hãy đo Recall(Tầng A) trên đúng domain triển khai thực tế.
Nếu Tầng A bỏ sót đối tượng, Tầng B sẽ không bao giờ có cơ hội.
5. So sánh với việc dồn cùng lượng compute đó cho tầng phía sau
Nếu cascade tốn thêm 5-10 ms mỗi frame, hãy tự hỏi:
Điều gì sẽ xảy ra nếu 5-10 ms đó được dồn trực tiếp cho detector phía sau?
Các phương án thay thế khả dĩ bao gồm:
- tăng độ phân giải input,
- model lớn hơn,
- fine-tune tốt hơn,
- tiling,
- inference đa scale (multi-scale),
- ROI camera tốt hơn,
- tổng hợp theo thời gian (temporal aggregation).
Cascade cần vượt qua các phương án thay thế đó, chứ không chỉ vượt qua baseline ban đầu.
Một checklist tổng quát cho cascade
Trước khi triển khai bất kỳ pipeline detect → crop → detect lại nào, giờ đây chúng tôi luôn tự hỏi:
Hình học
- Phân bố kích thước crop là gì?
- Độ phân giải input của tầng phía sau là bao nhiêu?
- Phân bố crop-to-input ratio ra sao?
- Có bao nhiêu pixel thật đại diện cho mục tiêu cuối cùng?
Recall
- Recall của tầng trước là bao nhiêu?
- Model ở tầng trước có được huấn luyện cho đúng domain camera này không?
- Trần recall lý thuyết mà tầng mới này tạo ra là gì?
Compute
- Tầng mới tiêu tốn bao nhiêu thời gian GPU?
- Cùng lượng compute đó có thể cải thiện trực tiếp model phía sau không?
Triển khai
- Mọi model có export được vào runtime production không?
- Các shape output có tương thích không?
- Batching có hoạt động không?
- Post-processing có được hỗ trợ không?
- Tracking identity còn hợp lý không sau khi thay đổi object hierarchy?
Đo lường
- Cả hai kiến trúc có được test trên cùng cảnh quay không?
- Trên cùng phần cứng không?
- Với cùng khung thời gian không?
- Với cùng ngưỡng ở tầng phía sau không?
- Kết quả có được đo bằng chương trình thay vì bằng mắt không?
Nếu những câu hỏi đó chưa có câu trả lời, việc chọn kiến trúc vẫn chủ yếu dựa vào cảm tính.
Mô hình tổng quát hơn
Dù chúng tôi phát hiện ra điều này thông qua bài toán nhận dạng biển số xe, nhưng mô hình này không chỉ riêng cho ANPR.
Nó xuất hiện ở bất cứ đâu một hệ thống thực hiện:
cảnh lớn
    ↓
phát hiện object cha
    ↓
crop
    ↓
phát hiện hoặc nhận dạng object nhỏ hơn
Ví dụ bao gồm:
- người → thẻ nhân viên (ID badge)
- khuôn mặt → mắt / landmark
- xe → biển số
- trang tài liệu → bảng
- bảng → ô (cell)
- cảnh → sản phẩm
- người → thiết bị / đồ bảo hộ (PPE)
Cùng những câu hỏi đó vẫn áp dụng:
Việc crop có thực sự bộc lộ thêm thông tin hữu ích cho model phía sau không?
Hay chúng ta chỉ đơn thuần phóng to một quan sát vốn đã có độ phân giải thấp?
Và:
Tầng phát hiện phía trước tạo ra trần recall nào?
Hai phép đo đó có thể cho bạn biết khá nhiều điều về việc một cascade có khả năng sống sót trên production hay không.
Khuyến nghị của chúng tôi
Đừng thêm một tầng detection ở phía trước chỉ vì một kiến trúc tham chiếu nào đó có dùng nó.
Và cũng đừng vội bác bỏ cascade.
Hãy đo trước.
Với bất kỳ pipeline crop-and-redetect nào, hãy bắt đầu với ba đại lượng:
1. Crop-to-input ratio
2. Số pixel nguồn thật trên mục tiêu cuối cùng
3. Recall của detector ở tầng trước
Nếu crop chứa đủ độ phân giải nguồn, detector ở tầng trước đủ vững trên đúng domain triển khai, và việc tách riêng ROI thực sự giúp đơn giản hóa bài toán phía sau, một cascade có thể cực kỳ hiệu quả.
Nếu crop bị upsample quá mạnh và detector ở tầng trước tạo thêm một cổng recall mong manh, việc thêm một tầng nữa có thể khiến hệ thống tệ hơn trong khi lại tốn thêm GPU.
Trên hệ thống production của chúng tôi, việc gỡ bỏ vehicle pre-filter và dồn compute trực tiếp cho plate detector cho ra kết quả +37% cải thiện phát hiện thực địa, mà không phụ thuộc vào hình học camera.
Đó là nguyên tắc chúng tôi hiện dùng khi đánh giá các detection cascade:
Tối ưu cho lượng thông tin thực sự đến được với model, chứ không phải cho số tầng có trong kiến trúc.
Và trước khi thay đổi kiến trúc, hãy đo nó trên chính chiếc camera sẽ thực sự vận hành nó.